
Midscene Bridge
@tnnevol/dsh-midscene 在本地托管一个 OpenAI 兼容的桥接服务,把 Midscene 的模型请求接到 DSH 宿主模型层——凡是 DSH 里能用的模型(DeepSeek 官方路由、CodeBuddy、Codex、你自定义的 OpenAI/Anthropic 兼容端点),Midscene 都能用。凭据、请求协议与 token 续期由各提供方插件在宿主内处理,桥不接触。
用途:让会话中的 agent 用自然语言驱动浏览器完成「打开页面 → 交互 → 断言」的 E2E 测试,替代逐步编排 chrome-devtools MCP 的日常用法。
安装
本插件不随 fnOS 应用(FPK)内置分发——浏览器自动化是用完即走的场景,需要时自行安装。任何 DSH 环境(含 fnOS 上的 DSH)都执行:
dsh plugin --profile web add @tnnevol/dsh-midscene@7.0.2安装后重启 DSH Web profile。插件版本信息见插件总览。
同一 DSH 里已安装的应用内置插件(fnOS、Codex Auth、Failover Search)随应用升级自动更新,与本插件互不影响。
桥接服务
插件启动后在 127.0.0.1 提供四个端点(只绑回环地址,不向局域网暴露)。端口默认 8787,被占用时自动向上尝试(最多 20 个),实际端口以插件设置页的接入配置预览或 /v1/midscene-env 为准:
四个端点里只有 /v1/chat/completions 会校验接入密钥:同一台机器上的其它进程同样能访问回环端口,密钥把「能访问回环端口的进程」与「持有接入配置的 Midscene」区分开。另外三个是发现类端点,不校验密钥,方便你直接复制命令排查。
| 端点 | 用途 |
|---|---|
GET /v1/models | 模型目录:DSH 当前全部可用模型,标识为「提供方/模型」形式 |
GET /v1/midscene-env | 生成接入配置:默认给出四行;为专用职责配了模型后,按职责追加对应变量组 |
POST /v1/chat/completions | 对话补全:流式(SSE)与非流式 |
GET /v1/health | 健康检查:提供方列表、模型数量、附件服务可用性 |
健康检查示例:
curl -s http://127.0.0.1:8787/v1/health # 若端口已自动跳号,用插件设置页显示的实际端口{
"status": "ok",
"host": "127.0.0.1",
"port": 8787,
"fixedModelName": "dsh-model",
"family": "glm-v",
"resolvedModel": "codebuddy/glm-5.3-flash",
"configuredModel": "",
"slots": {
"default": { "model": "codebuddy/glm-5.3-flash", "family": "glm-v", "dedicated": false, "source": "session" },
"locate": { "model": "codebuddy/glm-5.3-flash", "family": "glm-v", "dedicated": false, "source": "session" },
"planning": { "model": "codebuddy/glm-5.3-flash", "family": "glm-v", "dedicated": false, "source": "session" },
"insight": { "model": "codebuddy/glm-5.3-flash", "family": "glm-v", "dedicated": false, "source": "session" }
},
"providers": ["openai-codex", "deepseek-official", "codebuddy"],
"models": 24,
"attachments": true
}其中 port 是实际监听端口,resolvedModel 是当前会真正被调用的模型;slots 给出四个职责各自的模型、家族与来源(source 为 configured / session / fallback,dedicated 表示该职责是否单独指定了模型)。
端口不固定:默认从 8787 开始,被占用时自动尝试 8788、8789…(最多 20 个)。换成可用端口后:
- 插件会把实际端口写回配置,重启后直接用它(不会重复扫描);
- 启动日志会提示端口已变化,并要求重新拉取接入配置;
- 插件设置页与
/v1/midscene-env都返回实际端口。
端口变了要重新拉一次
.env:这是自动换端口的代价。若整段 20 个端口都被占用,插件会报错并列出尝试区间与处理建议(lsof -i :8787找到进程后停止它,或把配置的port改到空闲区间)。
想固定端口时,在插件配置里把 port 设为你想要的端口即可(仍会在占用时自动跳号)。
接入 Midscene
不需要准备任何模型 API key。 插件的存在意义就是让 Midscene 用 DSH 已经配好的模型:凭据在 DSH 的提供方插件里,桥不接触、也不转发。接入配置里那把密钥是桥自己的接入密钥(插件安装时自动生成),与任何模型服务商无关。
Midscene 强制要求四个模型环境变量(其中 MIDSCENE_MODEL_FAMILY 决定它的提示词模板与坐标解析协议)。插件知道 DSH 里有哪些模型,因此直接替你算好这份配置。
一条命令生成接入配置
这份配置有两个去处,内容完全相同,但只有第一个是常规必需:
| 去处 | 怎么用 | 何时需要 |
|---|---|---|
| 命令行 / 脚本 | 在运行 Midscene 命令的工作目录保存为 .env(Midscene 只加载当前目录的 .env) | 总是——推理发生在这一侧 |
| Midscene 浏览器扩展 | 打开扩展的侧边栏设置,把这四行粘进去 | 仅当你要用扩展自带的 Playground |
Bridge 模式下扩展不需要配模型。 扩展只当「眼睛和手」:截图、点击、输入;模型推理在跑脚本的 Node / CLI 侧完成。因此:
- 不给扩展任何模型配置,桥接自动化照样跑通;
- 反过来去掉 CLI 侧的
MIDSCENE_MODEL_NAME,会直接报Model configuration is incomplete: model name (MIDSCENE_MODEL_NAME) is required—— 报错点在 CLI 侧,这就是配置归属的判据。
唯一需要配扩展的是扩展自带的 Playground(在侧边栏里手写自然语言指令、由扩展自己驱动页面), 那是另一条链路。
curl -s http://127.0.0.1:8787/v1/midscene-env |
    python3 -c "import json,sys; print(json.load(sys.stdin)['content'])" >.env
得到的 .env:
# DSH Midscene Bridge 接入配置:四行都是固定值,换模型请改插件设置而非本文件。
# 协议:OpenAI Chat Completions(openai-chat)——本桥只提供这一种协议。
MIDSCENE_MODEL_BASE_URL="http://127.0.0.1:8787/v1"
MIDSCENE_MODEL_API_KEY="9f4c1d7a2b8e0356c1f09ad47b62e8d3"
MIDSCENE_MODEL_NAME="dsh-model"
MIDSCENE_MODEL_FAMILY="glm-v"| 变量 | 说明 |
|---|---|
MIDSCENE_MODEL_BASE_URL | 固定指向本地桥(含实际端口) |
MIDSCENE_MODEL_API_KEY | 桥的接入密钥:安装时自动生成的一串 32 位十六进制。它不是模型密钥,也不会被转发给任何提供方;但推理请求必须带上它,否则桥返回 401 |
MIDSCENE_MODEL_NAME | 固定写 dsh-model。Midscene 不需要知道 DSH 的模型标识,桥按这个名字决定实际用哪个模型 |
MIDSCENE_MODEL_FAMILY | 由插件按实际使用的模型推导(如 glm-5.3 → glm-v、gpt-6-luna → gpt-6、deepseek-flash → deepseek) |
该文件不含任何模型服务商的密钥,但仍建议放在不入版本管理的位置并确认
.gitignore覆盖它。
选模型
不指定模型时,桥按固定优先级挑一个:插件设置里指定的模型 → DSH 当前会话模型 → 目录里第一个具备识图能力的模型。会话模型是纯文本模型时会被跳过——Midscene 靠截图理解页面,纯文本模型跑不了。
查一下当前目录里有哪些模型:
curl -s http://127.0.0.1:8787/v1/models | python3 -c "
import json,sys
for m in json.load(sys.stdin)['data']:
    print(('IMG ' if m.get('vision') else '    ') + m['id'])
"
只有标记 IMG(vision: true)的模型能驱动 Midscene——它靠截图理解页面,需要图片输入。
模型在插件设置页选,不通过 URL 参数传——/v1/midscene-env 不接受 ?model=,它始终按当前设置生成配置。
关于 MIDSCENE_MODEL_FAMILY
插件按实际使用哪个模型推断家族,覆盖 Midscene 官方支持的主要系列(豆包 Seed、Qwen、智谱 GLM、Gemini、GPT、DeepSeek、Kimi、MiMo、UI-TARS、AutoGLM)。每个职责各自推导,互不串用。
- 识别不出家族的模型(如 CodeBuddy 的
hy3、space-bunny、minimax-m3)回落到通用协议glm-v:它在 Midscene 未适配的识图模型上实测可正常定位,比让用户自己猜家族值更省事。 - 家族不出现在界面上,也不需要你设置:它是「按哪个模型对话就该用哪套坐标协议」的推论,写错的表现是点击偏几像素而不报错。
跑一条命令
npx -y @midscene/web@1 connect --url https://example.com
npx -y @midscene/web@1 act --prompt "点击登录按钮"
npx -y @midscene/web@1 assert --prompt "页面显示登录表单"
npx -y @midscene/web@1 close
内置技能
安装插件后,7 个 Midscene 技能会直接出现在会话的技能目录里,无需再执行 npx skills add:
| 技能 | 平台 / 定位 |
|---|---|
browser-automation | 浏览器(Puppeteer / CDP / Bridge 三种模式) |
computer-automation | 桌面(macOS / Windows / Linux) |
android-device-automation | Android(ADB) |
ios-device-automation | iOS(WebDriverAgent) |
harmonyos-device-automation | HarmonyOS(HDC) |
vitest-midscene-e2e | 用 Vitest + Midscene 写跨平台 E2E |
midscenejs | 知识与 API 参考(概念、模型与 FAMILY、四职责模型、Agent API、YAML 运行器、Midscene Test、CI 集成) |
前 6 个来自官方 midscene-skills(与 Midscene 官方文档「支持的平台」一一对应),midscenejs 来自 tnnevol/skills。来源与版本见包内 skills/SOURCE.md。
midscenejs 当前快照对齐 Midscene v1.16.0(skill 1.1.0),包含定位模型独立槽位(MIDSCENE_LOCATE_MODEL_*)、jev 家族与它的适用边界、Puppeteer Test Node、资源清理语义强化,以及 CI 里运行 Midscene Test 的说明。
插件运行时依赖的 Midscene 库基线是 1.16.5,比这份技能快照(v1.16.0 文档源)新。差距来自上游:
tnnevol/skills的midscenejs尚未跟进到 1.16.5。1.16.1~1.16.5 对本插件的影响只有maxConcurrency的重命名与几项增量能力(AUTH_MODE、文件级 setup、环境准备超时),不改变四职责模型、家族推导与接入配置的任何用法,因此技能内容仍然适用。
技能内容与官方逐字节一致:插件不改上游文件,升级时整目录覆盖即可,不存在需要重新施加的补丁。
模型来源:由插件注入的环境说明
官方技能面向 Midscene 通用用户,其「模型配置」节会教 agent 申请 Gemini/豆包等第三方 API key;而本插件的意义是让 Midscene 用 DSH 已有模型(桥托管本地端点、零第三方密钥)。两者直接冲突。
做法是分发时注入一段环境说明,而不是改文件——agent 读到的技能内容 = 环境说明 + 官方原文。说明里告知:本环境用桥、配置是固定四行、不要向用户索要模型 API key;官方原文中的服务商与 key 示例仅作背景知识。
这样技能文件与官方保持一致且可核对,同时 agent 不会照抄官方示例去要密钥。
移动端/桌面的 CLI 包(
@midscene/android等)不由插件提供;技能执行时用npx -y @midscene/<平台>@1按需拉取,插件不必为未使用的平台背负依赖。桌面自动化在本地模式会接管真实鼠标键盘,使用时留意。你自行安装的同名技能优先(插件注册的技能在发现优先级里排在项目与用户目录之后),插件不覆盖、不重复提示。卸载插件后内置技能同步消失。
其他运行方式
Midscene 的三种运行方式读取同一套模型环境变量,接入配置一次写好即可共用:
| 运行方式 | 命令 | 说明 |
|---|---|---|
| 即席 CLI | npx -y @midscene/web@1 ... | 上面的 connect / act / assert |
| YAML 脚本运行器 | midscene(@midscene/cli) | tasks/flow 格式脚本,可生成可视化报告 |
| Midscene Test | midscene-test(@midscene/test) | 声明式 YAML 用例 + TypeScript 自定义 Node;当前处于 Beta |
桥接侧不为任何一种方式增加专用端点——三者都打同一个 /v1/chat/completions。
额度提示:Midscene 每一步操作都要调用视觉模型,因此按所选提供方计费。多步骤任务会消耗较多额度;Midscene 自带缓存可减少重复调用。建议先用小页面验证流程,再跑长任务。
故障排查
| 现象 | 原因与处理 |
|---|---|
连接被拒绝 / ECONNREFUSED | 桥接服务未启动,或端口已自动跳号。启动日志会写明实际端口;也可在插件设置页的接入配置预览里看 MIDSCENE_MODEL_BASE_URL。确认 DSH 在运行且插件已启用 |
| 之前能用、现在连不上 | 端口被占用后插件换了端口,.env 仍指向旧端口。重新拉一次 /v1/midscene-env 覆盖 .env 即可 |
| 启动日志报端口冲突 | 8787 被别的进程占用。lsof -i :8787 找到并停止它,或修改插件配置的 port 后重启 DSH |
401 invalid_api_key | 请求带的接入密钥与桥当前的不一致(常见于在设置页重新生成过密钥后 .env 还是旧的)。重新拉一次接入配置覆盖 .env 即可 |
| 404 且提示「本桥只提供 Chat Completions」 | 把协议设成了 openai-responses。本桥只提供 Chat Completions,请把 MIDSCENE_MODEL_PROTOCOL 设回默认的 openai-chat |
| 404 且提示「Jev 的私有协议不经本桥」 | 请求打到了 /v1/systemone。Jev 用的是私有 System One 协议,请改用通用模型作默认模型 |
MISSING_CREDENTIAL | 所选提供方未配置凭据。桥返回的错误会指名「提供方/模型」,按提示到 DSH Web 设置里登录(CodeBuddy / Codex)或补齐 API key(如 DEEPSEEK_API_KEY) |
QUOTA / ACCOUNT_QUOTA | 该提供方额度或余额不足。换一个「提供方/模型」或到对应平台充值 |
no such provider / 模型路由错误 | 模型名写错了,或该提供方插件未安装。用 /v1/models 核对准确标识(注意是「提供方/模型」全称,不是裸模型名) |
| 模型家族不匹配 / 定位不准 | MIDSCENE_MODEL_FAMILY 与所选模型不符。只在手工改过 .env 时出现:删掉该行重新拉取配置即可。也可用 Midscene 的 --deep-locate 提升定位精度 |
| 图片请求被拒(400) | 所选模型不具备图片输入能力。改用 /v1/models 里 vision: true 的模型 |
技能目录里看不到 browser-automation | 插件未启用或未安装。确认插件管理页里本插件为启用状态并重启 DSH;若你自己装过同名技能,以你的版本为准 |
| 定位偏几像素 | 家族与实际模型不匹配。正常不会发生(插件按模型自动推导);若手工改过 .env 里的 MIDSCENE_MODEL_FAMILY,删掉该行重新拉取配置 |
| npm 权限报错 | npx 首次运行需要写 npm 缓存目录。按系统提示修正 ~/.npm 权限,或设置 npm_config_cache 指向可写目录 |
隐私与边界
- 桥不读取、不存储、不转发任何凭据:请求经宿主模型层路由,凭据解析与续期在对应提供方插件内完成。桥只校验自己那把接入密钥。
- 桥只监听回环地址,推理请求需带上接入密钥;发现类端点不校验。请不要把端口暴露到局域网。
- 桥的日志只记录每次请求的一行摘要(模型、流式/缓冲、消息条数),不含消息内容与图片数据;可用配置项
logRequests: false关闭。 - 图片以数据 URI 交给桥后,会经 DSH 的附件服务落成受管附件(与你在会话里发图片走同一套机制),不绕过宿主的图片策略。
- chrome-devtools MCP 不受影响,可继续使用。
配置项
插件的配置分两处:DSH 官方的插件配置表单承载标量字段,插件详情页的「Midscene 接入设置」区块承载需要交互的字段(接入密钥与各职责使用的模型)。
| 配置 | 默认值 | 说明 |
|---|---|---|
port | 8787 | 首选监听端口;被占用时自动向上尝试(最多 20 个),并把实际端口写回该字段 |
apiKey | 安装时自动生成 | 桥接接入密钥;可在「Midscene 接入设置」区块重新随机生成或自定义 |
family | glm-v | 协议家族,自动维护:桥按实际使用的模型推导,通常不需要手工设置 |
model | 空 | 指定用于 Midscene 测试的模型;留空则跟随 DSH 当前会话模型 |
requestTimeoutMs | 300000 | 单次模型请求超时(毫秒);0 表示不超时 |
logRequests | true | 是否记录每次请求的一行摘要日志 |
port、requestTimeoutMs、logRequests 这类标量字段由 DSH 官方配置表单渲染,可以直接编辑,改动立即作用于运行中的桥,不需要重启 DSH。
在真实 Chrome 中驱动(Bridge Mode)
Midscene 官方支持 Chrome 桥接模式:本插件的验证脚本作为服务端(默认 127.0.0.1:3766), 你 Chrome 里的 Midscene 扩展反向连接过来,从而用自然语言控制你自己的浏览器。
| 维度 | Bridge Mode | CDP 直连 |
|---|---|---|
| 浏览器窗口 | 用户可见 | 不可见(headless) |
| cookies / 登录态 | 复用你的真实环境 | 全新 profile |
| macOS 钥匙串弹窗 | 无 | 每次新建 profile 都可能弹 |
| 视口 | 你的真实窗口 | headless 默认 756×413,侧边栏会收缩为图标态 |
前提条件(一次性):Chrome 安装 Midscene 扩展,首次连接时在扩展弹窗点 Allow(或 Always Allow 后续免确认)。
扩展不需要配模型。 桥接模式下推理发生在跑脚本的这一侧,扩展只当「眼睛和手」:截图、点击、输入。 所以「扩展里没填模型」不会导致连不上——能否连上只取决于扩展装没装、首次连接有没有点过 Allow。 反向判据:把 CLI 侧的 MIDSCENE_MODEL_NAME 去掉,报错会出在 CLI 侧 (Model configuration is incomplete: model name (MIDSCENE_MODEL_NAME) is required)。
只有让用户用扩展自带的 Playground(在侧边栏里手写指令、由扩展自己驱动页面)时,才需要把 接入配置粘进侧边栏设置 —— 那是另一条链路。
# 1) 取接入配置(四行固定值;端口以 /v1/health 的 port 字段为准)
#    存为运行 Midscene 命令的工作目录下的 .env —— 桥接会话的脚本会从这里读
curl -s "http://127.0.0.1:8787/v1/midscene-env" |
    python3 -c "import json,sys; print(json.load(sys.stdin)['content'])" >.env
# 2) 运行(目标 URL 用带 token 的完整地址)
pnpm --filter @tnnevol/dsh-midscene run test:bridge "http://127.0.0.1:8070/?token=…"
标签页纪律
测试操作的是你真实浏览器里的标签页,因此脚本遵守四条纪律:
- 先查后复用:连接前先列标签页,目标站点已打开就直接绑定它,不重复开页(同源同路径即视为同一页——DSH Web 的
?token=会随重启变化,按完整 URL 比较会让复用失效)。 - 复用后回到确定起点:复用的页面可能停在上次测试留下的状态,脚本会先把目标地址重走一遍再开始用例。
- 收尾至少保留一个目标页:便于你复核结果。
- 只关闭本次多开的重复页:复用来的页面不受影响(Midscene 只清理它自己新建的页)。
脚本位于包内 scripts/bridge-smoke.ts。它会做两件事:断言首页可见、点击侧边栏进入插件列表—— 每步都用页面内状态独立核实,交互未生效时自动重试一次(Midscene 的单次点击可能不触发行为, 详见测试规范的 Midscene 章节)。
桥接模式复用桌面浏览器配置,因此 viewportWidth、userAgent、cookie、extraHTTPHeaders、 chromeArgs 等选项会被忽略。模型配置必须放在 Node 侧(终端环境变量)——本仓库的 .env 约定正合此要求。
各职责使用的模型(Tabs)
Midscene 把模型按职责分成四类,插件用 Tabs 分别配置(对应上游的 MIDSCENE_*_MODEL_* 四组变量):
| Tab | 职责 | 留空时 |
|---|---|---|
| 默认 | 所有职责的基础模型 | 跟随 DSH 当前会话模型(需具备识图能力) |
| 定位 | 元素定位与 deepLocate | 沿用默认职责 |
| 规划 | 多步骤规划与分支判断 | 沿用默认职责 |
| 页面理解 | 断言、数据提取、aiQuery / aiAsk | 沿用默认职责 |
只配默认就够了。专用职责是可选优化:界面控件小、点击定位不稳时换一个更擅长定位的模型,长流程分支多时给规划单独配一个,通常比反复调提示词有效。每个 Tab 都会显示「当前实际使用」的模型,据此能确认留空是否按预期回落。
下拉里只列出具备识图能力的模型——Midscene 靠截图理解页面,纯文本模型选进来也跑不了。指定的模型在目录中不存在时,插件会如实提示(保留原选择、不静默改选别的)。DSH 里一个识图模型都没有时,整块显示一条提示(说明需要先安装并登录一个提供方),而不是给空下拉。
为什么每个职责只让选一个、不让选列表:协议家族由该职责实际使用的模型推导,而它在启动期读入后只有一个。多选若混入不同系列,回退到备用模型时家族仍是最初那个,反而造成静默错位;同族备用能救的场景又极少。
接入配置只在配置后才变长
默认只有四行。你为某个职责指定模型后,该职责才会追加一组变量(并在文件里带一行注释说明)。没配的职责不写,Midscene 自己回落到默认模型:
# 只配默认职责时(全部留空也是这样)
MIDSCENE_MODEL_BASE_URL="http://127.0.0.1:8787/v1"
MIDSCENE_MODEL_API_KEY="…"
MIDSCENE_MODEL_NAME="dsh-model"
MIDSCENE_MODEL_FAMILY="glm-v"# 另外配了「定位」之后,多出这一组
# 以下为「定位」职责单独指定的模型;不配置则沿用上面的默认模型。
MIDSCENE_LOCATE_MODEL_BASE_URL="http://127.0.0.1:8787/v1"
MIDSCENE_LOCATE_MODEL_API_KEY="…"
MIDSCENE_LOCATE_MODEL_NAME="dsh-model@locate"
MIDSCENE_LOCATE_MODEL_FAMILY="deepseek"
MIDSCENE_LOCATE_MODEL_STREAM_MODE="non-stream"模型名带 @职责 后缀是桥的路由依据:桥据它判断这次调用属于哪个职责,再打到该职责配置的模型上。所以四组不能共用一个名字——共名会让专用职责的模型永远不被用上。已经写好的四行 .env 不需要重新拉取;只有你在设置页新增了专用职责才需要更新它。
协议家族是自动的
Midscene 需要一个 MIDSCENE_MODEL_FAMILY(协议家族)才能解析模型返回的坐标,而它的取值取决于实际使用哪个模型。这件事由插件在生成接入配置时自动完成,不需要你设置、界面上也不出现:
- 能识别出家族的模型 → 用对应家族(
glm-*→glm-v,deepseek-*→deepseek,autoglm-*→auto-glm,依此类推); - 识别不出、但具备识图能力的模型(Midscene 未适配的系列,如
codebuddy/hy3)→ 使用通用协议,同样可以正常使用; - 家族随模型变化自动更新:换了模型,
.env里的家族跟着变。
之所以不把它做成选项:家族是 Midscene 的内部协议细节,让用户选择既要求理解提示词模板与坐标解析,又必然产生「家族与模型不匹配」的组合——而那种组合的表现是点击偏几像素的静默错位,不报错、极难排查。
跟随会话模型时同样安全:若会话当前用的是纯文本模型,桥会跳过它、改用目录里其他识图模型(而不是让 Midscene 因为无法识图而失败)。
换模型后需要重新拉取一次
.env(家族写在里面)。设置页的「复制接入配置」或GET /v1/midscene-env都能拿到最新值。
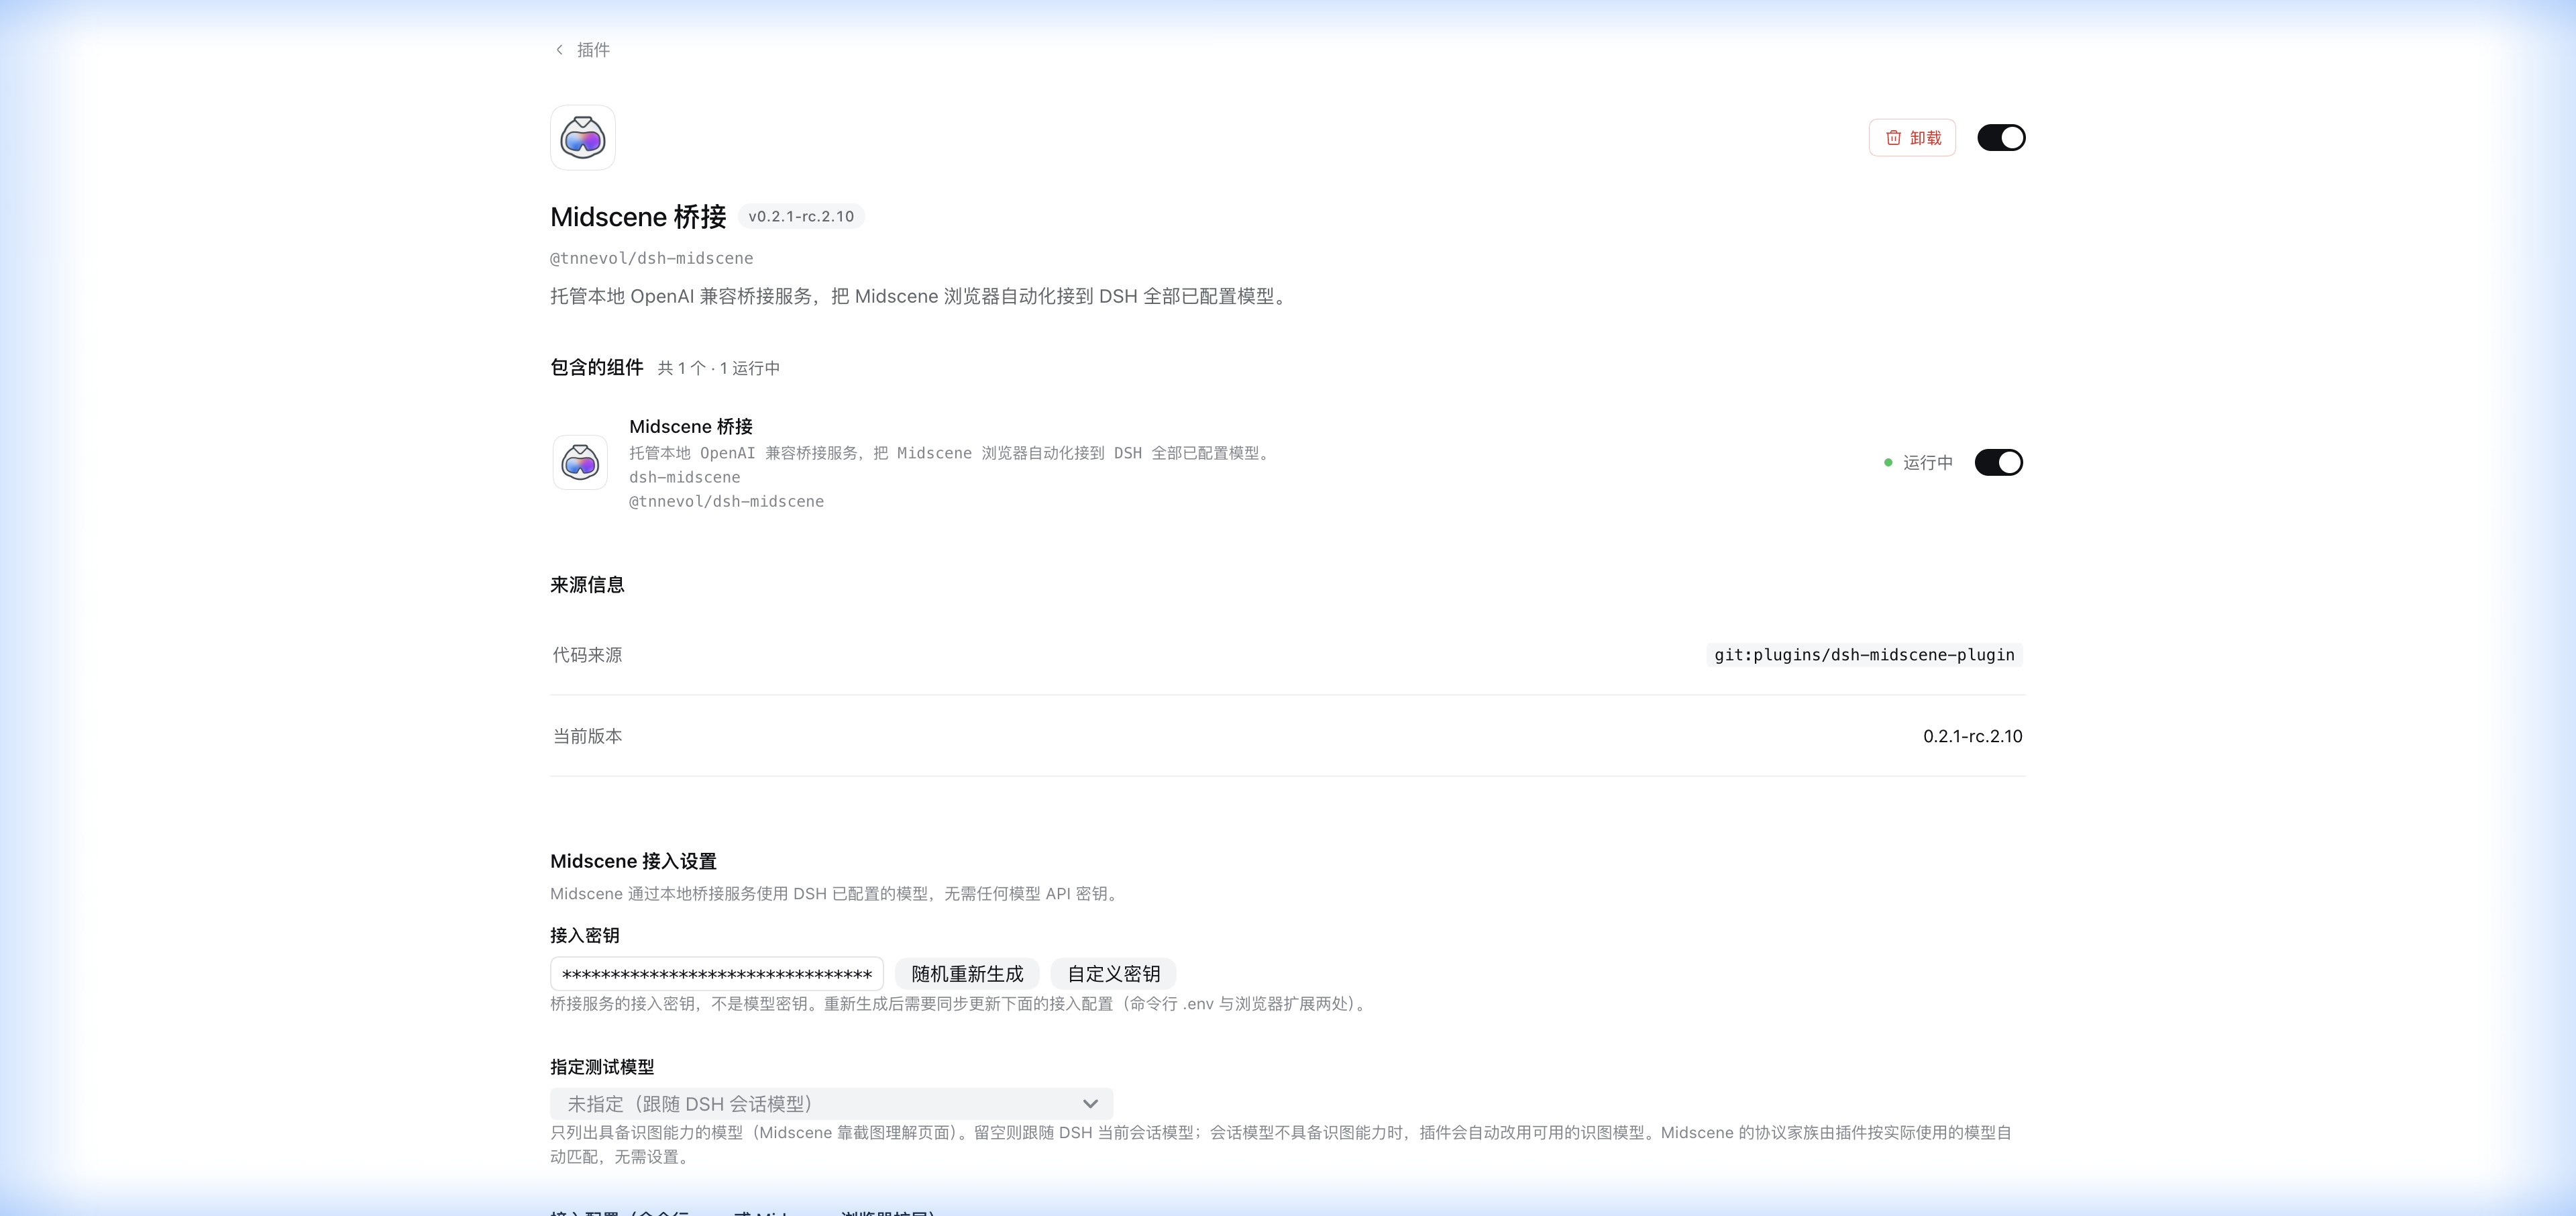
插件设置页
在 DSH 的插件管理页点开本插件,组件列表下方有「Midscene 接入设置」区块:
| 设置项 | 说明 |
|---|---|
| 接入密钥 | 安装时自动生成;可一键随机重新生成,或自定义。生成后需同步更新 Midscene 的 .env(重新拉一次即可) |
| 各职责使用的模型 | 四个 Tab(默认 / 定位 / 规划 / 页面理解),每个一个下拉(可搜索、可清空),选项只含支持图片的模型。默认留空跟随 DSH 会话模型;其余留空沿用默认 |
| 接入配置 | 直接显示当前接入配置全文,可一键复制(命令行 .env 与 Midscene 浏览器扩展两处都用它) |
协议家族不出现在这个区块里:它由每个职责实际使用的模型推导,界面不呈现这个概念。
各职责的模型用下拉而不是手填:手填要求记住「提供方/模型」全称(如 codebuddy/glm-5.3-flash), 写错只会在真正跑 Midscene 时才报错,而用户也无从知道有哪些合法值。下拉选项与 /v1/models 同源 (同一份目录缓存),不会出现「界面上能选、桥上查不到」的不一致;已配置但当前目录中不存在的模型 (提供方被卸载或模型改名)会以提示标出,不静默丢弃。
改动立即作用于运行中的桥(无需重启 DSH);端口、超时、日志开关等标量字段由 DSH 官方设置表单承载。
接入配置由插件生成
/v1/midscene-env 生成的配置在每次请求时按当前模型目录实时计算——新增提供方、换模型后重新拉一次即可,不需要记忆任何变量取值,也不需要为任何模型准备密钥。
能力边界
插件的定位是让 Midscene 用上 DSH 已有的模型,不是把 DSH 的全部协议能力在桥里再实现一遍。下面几件事看着像「缺功能」,其实是有意为之。
结构化输出被忽略,但不是缺陷
Midscene 的各家族适配器会在请求里带上 response_format: { type: "json_object" },要求模型按 JSON 回复。桥不读这个字段,直接忽略,请求照常成功。
为什么不改成报错:
- 该字段自 1.15.1 基线起就一直随请求发出,桥也一直在忽略——现有功能与全部验收用例都是在这个状态下通过的;
- 改成 400 等于把今天可用的功能推成失败;
- Midscene 对解析失败自带兜底:解析不过时它会把错误回灌给模型、要求修正后重试(默认重试一次)。所以结构化输出只是提高首轮命中率的优化项,不是功能成立的前提。
你看到的现象:模型返回的不是 JSON 时,Midscene 自己会重试一次;你看到的是 Midscene 侧的语义重试,桥不会报错。
为什么不需要 Responses 协议
Midscene 支持把协议切成 openai-responses。本桥只提供 Chat Completions 一种协议,也不需要提供 Responses:
- DSH 已在宿主内把各提供方的上游协议归一(Codex 走 responses、CodeBuddy 走私有形态,都由各自的适配器处理),桥对外只暴露 Chat Completions 就能触达 DSH 全部已配置模型——这一点经实桥逐提供方实测(
openai-codex、za-newapi、codebuddy、opencode-go、dsh-opencode-go)全部正常返回; - 宿主本身也没有协议选择入口,调用方无法要求宿主改走另一种协议;
- 因此在桥里实现
/v1/responses不会多覆盖任何模型,只是多一条进入同一批模型的路径,还要自建一套并行的请求/响应词汇。
生成的接入配置里已经写明本桥使用的协议,不需要你自行判断该配哪一种。
误配时的表现:你若自行把协议设成 openai-responses 并把请求打到 /v1/responses,桥会返回 404,并在响应里附带可读指引:本桥只提供 Chat Completions,请把协议设回默认的 openai-chat。
Jev 为什么不经过本桥
Jev 用的是 TypeSafe 的私有 System One 协议(POST {base}/v1/systemone),不是 OpenAI 协议;上游也明确它不能作为默认模型(作为默认模型时上游会直接抛错)。桥要支持它等于自建一套私有协议适配,与「用 DSH 已有模型」的插件定位不符。
误配时的表现:把请求打到 /v1/systemone 同样会得到 404,附带指引:Jev 的私有协议不经本桥,请改用通用模型作默认模型。
模型原生思考开关
Midscene 默认关闭模型原生思考(各家族适配器会在请求里带上 thinking.type、enable_thinking、reasoning_effort 之类的字段)。桥会如实识别这个意图,并映射到宿主支持的思考档位:
- 模型支持对应档位 → 按 Midscene 的设定生效;
- 模型不支持 → 不传该设置,请求照常发出(不会返回
UNSUPPORTED_REASONING_EFFORT),行为退化为与升级前一致。
取舍是「宁可少传,不可乱传」:传一个模型不存在的档位会让请求直接失败,而不传只是沿用模型的默认行为。
不用 ChatGPT 订阅(SIWC)模式
Midscene 1.16.5 起,四组模型变量都多了一个 AUTH_MODE,可选 api-key(默认)或 siwc。siwc 是「用 ChatGPT 订阅身份访问、不走 API Key 计费」的接入方式,本插件不使用它:
- 桥用的是自己的接入密钥(
api-key),模型凭据的解析与续期留在 DSH 的提供方插件里,桥不接触; - 改成
siwc等于绕过 DSH 的模型层、把订阅凭据直接交给 Midscene,与「零第三方密钥」的定位冲突; - 该变量缺省就是
api-key,所以不需要任何配置——你不用管它。
误配时的表现:若你照上游文档把 MIDSCENE_MODEL_AUTH_MODE 设成 siwc,Midscene 会按订阅身份去连本桥,而桥只认自己的接入密钥,请求会因鉴权不符失败。把它删掉(或设回 api-key)即可。
图标来源
插件图标取自 Midscene 官方站点 favicon(https://midscenejs.com/favicon.png,600×600 PNG,Midscene 主仓库 MIT 许可),随 npm 包分发、无外部请求。来源与取用日期登记在包内。
相关页面
- 插件总览
- 测试用例文档规范——Midscene 浏览器自动化作为 UI 走查与 E2E 用例的执行方式
- 本地 DSH Web
- Midscene 官方文档